调数值手感对了,写给 AI 就跑偏:把游戏设计知识翻译成可执行 Prompt
概述
这是一篇写给「做过小游戏或关卡原型、听过核心循环和心流曲线但说不出怎么用」的设计实践者的专题。你已经把"先定玩家反复做的动作、再搭场景"和"反复调数值调到手感对"走了一遍——这是设计流程的前半段,缺的是把零散直觉升级成体系化的判断标准,以及把它翻译成大模型能稳定执行的 Prompt。
专题的前半段解决第一个问题:核心循环、心流通道、Schell 七要素、MDA 三层到底在说什么;Schell 的 Rule of the Loop、Eight Filters 如何与关卡设计的四个参数(难度曲线、引导教学、奖励频率、失败成本)一一对应。后半段解决第二个问题:把前面那些设计词汇喂给 Gemini、文心一言等大模型时,如何用"角色-目标-约束"三元骨架写出稳定的 Prompt,并通过四类实战模板(创意发散、核心循环设计、关卡生成、数值调优)跑通迭代闭环。最后给出两类判断标准(好玩度量化、什么时候该换方向),同时明确 AI 协作的边界。
1. 破题:从"调数值"反推"好玩"这个最小单元
1.1 你调的手感是什么
回想你上一次调数值的过程:试一次,敌人太快,调慢一点;再试一次,奖励间隔太长,砍掉几秒;又试一次,拾取反馈太弱,加大特效。通常你会反复改同一个动作相关的几个参数,直到"手感对了"。这个动作几乎从来不是"按一个键打一个怪"那么抽象,而是已经被你拆到"移动 + 拾取 + 拾取反馈 + 升级选择"这种具体的最小可观测单元。
Vampire Survivors(吸血鬼幸存者)是最纯粹地把这件事摆出来的例子。poncle 创始人 Luca Galante 在采访里说过一句流传很广的话:"I didn't have a vision, I just put elements in to try and make things fun." 这款 2021 年底上线的独立游戏把"好玩"压缩到了极简:角色只会向摇杆方向移动,攻击由系统自动完成,敌人和宝石向角色涌来,玩家只需要在捡宝石升级时挑一个选项。

图注:游戏开局 20 秒的截图。HUD 顶部是 00:20 计时、3 颗心、金币数和击杀数;中央是戴绿帽的小角色,约 10 只蝙蝠形敌人环在周围,地面有一个浅色的武器攻击范围圈,8 颗浅蓝自动攻击弹正在向外辐射。这张图展示的核心循环的输入端是"移动 + 被动接收自动攻击 + 拾取经验",不是"满屏弹幕"。
为什么挑这张早期而不是后期?后期的视觉过载(约 26 分钟、24948 次击杀)会让你以为"这就是核心循环的样子",但实际上是奖励频率按指数曲线叠加的结果。早期这张图才是"最小动作单元"的可视化锚点:你只需要关心三件事,移动方向、自动攻击弹的覆盖范围、以及什么时候捡到经验宝石。把这三件事调到心流通道里,手感自然就对了。
这一段对应 Schell 在《The Art of Game Design》里讲的核心循环(Core Loop):玩家在一局/一关里反复做的最小动作单元。它属于 Schell 七要素里 Mechanics 维度的子集,是"好玩"这件事能被观察到的最底层。Schell Lenses
1.2 心流通道:把"凭感觉"换成"看坐标"
"手感对"听上去很玄,但 Csikszentmihalyi 早在 1990 年的《Flow: The Psychology of Optimal Experience》里给出了一个可测量的坐标系。Jenova Chen 2006 年的 USC 硕士论文把这条心理学理论翻译成了游戏设计语境:纵轴是挑战(Challenge),横轴是玩家的能力(Abilities),中央有一条绿色的 Flow 椭圆带,左上方(高挑战低能力)叫焦虑(Anxiety),右下方(低挑战高能力)叫无聊(Boredom)。Flow Theory via Chen 2006

图注:Csikszentmihalyi 原始的 Flow Zone 图。L 型绿色坐标轴,纵轴 Challenge、横轴 Abilities;中央椭圆带标 FLOW,左上 Anxiety,右下 Boredom。这张图是心流理论的"工程蓝图"——调数值的目标就是让玩家的技能曲线落在中央那条带里。
这张图给你的真正价值不是告诉你"心流是什么",而是把"调数值"重新定义成"看坐标"。你之前凭感觉改敌人速度,本质上是把某个动作的难度坐标向上或向下移动;你后来改奖励频率,本质上是让玩家感受到的能力坐标同步移动。两个坐标都落在 Flow 带里,就是"手感对了";一个偏高就是焦虑,偏低就是无聊。
Chen 的论文还顺带提到一项对游戏设计特别有用的副产品:心流的 8 个组件里,与游戏最相关的有 3 条——清晰的目标(Clear goals)、即时的反馈(Direct feedback)、挑战与技能的匹配(Challenge-Ability Balance)。这三条恰好对应后面要展开的"角色-目标-约束"三元 Prompt 的天然语义来源:清晰的目标可以装进 Goal,即时的反馈可以装进 Rules,挑战与技能的匹配则是你每一次试跑要观察的指标。
1.3 把这一节收束成一句话
你之前调的手感,是把一个核心动作的"难度-技能"配比落在心流通道里。这就是把直觉升级为可命名单元的第一步。但这一节只解决"这是什么"的问题,还没有回答"它属于哪个设计要素?不同要素之间怎么咬合?"——下一节用两个互补框架拆给你看。
2. 双框架拆解:七要素坐标系与 MDA 因果链
2.1 Schell Elemental Tetrad:四个稳定抓手
Jesse Schell 的《The Art of Game Design》给出了拆解任何游戏的四要素坐标系:Mechanics(机制)、Story(故事)、Aesthetics(美学)、Technology(技术)。四个要素并列存在,但在玩家感知上有可见度梯度——Aesthetics 最容易被玩家看见(画面、声音、触感),Mechanics 和 Story 在中间层,Technology 最不容易被直接感知(它通过机制和故事间接传达给玩家)。Schell Lenses

图注:菱形布局的四要素图,顶端 Aesthetics,左侧 Mechanics,右侧 Story,底部 Technology;右侧附箭头标注 "More Visible"(顶端)到 "Less Visible"(底端)的可见度梯度。这张图是 2008 年第 1 版的示意图,由 First Person Scholar 在 2014 年学术综述中改编重绘,是拆解"为什么这款游戏好玩"的第一张坐标系图。
四个抓手在你做原型时各承担不同的判断责任。Mechanics 是你调数值的那一摊——攻击伤害、移动速度、拾取范围都属于这里。Story 是玩家为什么做这件事的叙事理由,但 Story 不只是剧本:它在玩法层面表现为"敌人为什么要打我""我为什么要去那个方向"。Aesthetics 不只是美术风格,它是节奏控制的中介——像素风、自然音效、慢节奏这些东西本身就是设计意图的载体,详见 Stardew Valley 那条反例。Technology 是支撑前三个要素的媒介和引擎——它通过 Mechanics 间接被玩家感知,所以 Technology 维度极致的设计(如《塞尔达:旷野之息》的物理 × 化学引擎)往往看上去就像 Mechanics 很巧妙。
四个抓手不是孤立的标签,它们彼此咬合。Schell 自己给了一句自问:如果我的四个要素彼此和谐、共同强化同一个主题吗?这句自问比"四要素分别是什么"更有教学价值,因为它逼你去看每个要素的设计是否在讲同一件事,而不是各自精彩。
2.2 MDA:因果断层与反向视角
七要素给的是坐标系,MDA(Hunicke、LeBlanc、Zubek 2004)给的是因果链。三个字母各代表一层:Mechanics(数据/算法层的具体组件)、Dynamics(机制在玩家输入与彼此输出下的运行时行为)、Aesthetics(玩家与系统互动时产生的期望情感响应)。MDA Framework

图注:M / D / A 三个浅蓝色方块横排,左侧红色笑脸标 Designer,右侧绿色笑脸标 Player;红色虚线箭头从 Designer 一侧指向 A(自左向右),绿色虚线箭头从 Player 一侧指向 M(自右向左)。这张图是 MDA 框架最关键的洞见:设计师的工作流是 M→D→A(自底向上建构),玩家的工作流是 A→D→M(自顶向下体验)。你写的数值落在 Mechanics 层,玩家感受到的是 Aesthetics 层——中间隔着 Dynamics 的涌现。
MDA 的核心洞见是反向视角。设计师能控制的只有 Mechanics,Dynamic 和 Aesthetics 都是涌现:玩家不会直接接触你写的伤害公式,他只会接触到"我打这一下爽不爽"。这条因果单向是你在调数值时最容易忽略的判断依据——你改一个 Mechanics 参数,期望 Dynamics 出现某类行为,玩家接收到的是某类情感;任何一环断了,链条就断了。
MDA 不是 Schell 的替代品,而是另一个切片。Schell 七要素给你的是"桌面上要摆哪几类元素",MDA 给你的是"这些元素如何级联成玩家体验"。本专题把两个框架并置:先用七要素列四个维度的证据点,再用 MDA 看哪些是设计师给的规则、哪些是玩家实际感受到的涌现。
2.3 把 BotW 的三角地形钉在 Mechanics × Technology 维度
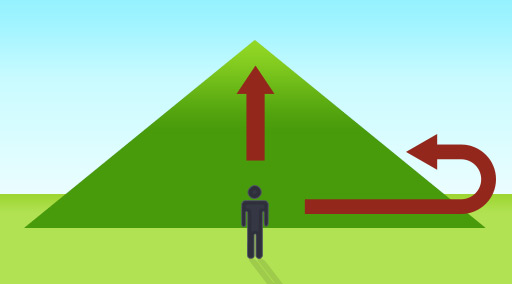
《塞尔达:旷野之息》(BotW)2017 年的 CEDEC 演讲和 GDC 演讲是 Technology 维度做到极致的代表作。Fujibayashi 与 Yonezu 在 CEDEC 演讲里把"为什么 BotW 的开放世界感觉那么自然"拆成了两条规则:三角地形法则(Triangle Rule)和重力法则(Gravity Rule)。BotW Field Level Design
三角地形法则的关键观察是:地形做三角形有两条天然好处。第一,玩家面对三角形山坡时会被迫做一个"翻过去还是绕过去"的二选一决策——这就是 Choice。第二,无论走哪条路径,原先被山遮挡的部分都会随着视角变化而逐渐显现——这就是 Reveal。三角形的两条边把"选择"和"揭示"两件事同时解决。

图注:4gamer 自绘的示意图。中央一棵大绿色等腰三角形(代表 landmark),底部有一个玩家小人,红色的向上箭头表示"翻越",红色的弧形箭头表示"绕行"。这张图被 Nintendo 要求从原演讲 slide 中撤稿后,由 4gamer 自行重绘替代。
BotW 把三角地形法则用在三个尺度上:大三角是远景 landmark,玩家从地图任何地方都能看见,决定"接下来去哪里";中三角是遮挡物,玩家走过时会突然发现神庙或敌人营地;小三角是节奏控制,玩家在平原上跑动时会不断碰到小土堆,迫使方向微调。这三套叠加的效果是:玩家永远有事可做,但永远不觉得"被 quest compass 拖着走"。
Dohta 在 GDC 演讲里补充了另一半:物理引擎(Havok)和化学系统。化学系统不是物理引擎,它是一个基于规则的状态计算器——三条规则:元素(火、水、冰、风、电)可以改变材料状态、元素之间可以相互改变、材料之间不能相互改变。"烹饪"就是这个系统的特殊案例:火烤时间 + 锅内食材 → 一道菜(综合属性效果)。这套 Technology 维度上的设计直接驱动了 Mechanics 维度的涌现——柴刀砍树、磁铁吸金属、火点燃草地,这些本来是分散的机制,被化学规则串成一个可组合系统。
把 BotW 放在这里不是为了背它的细节,而是为了说明一个反复出现的判断:当 Technology 维度的引擎本身就是机制时,把它归入 Mechanics 还是 Technology 已经不重要——重要的是认识到这是 Technology × Mechanics 的极致联动,不能拆开讲。
2.4 把 Stardew 的反过度刺激钉在 Aesthetics 维度
如果 BotW 是"加法做到极致"的代表,星露谷物语(Stardew Valley)就是"减法做到极致"的代表。ConcernedApe(Eric Barone)在 2026 年 2 月 IGN 十周年访谈里直接说了一句设计原则:"I don't want to keep adding systems, but I do feel like all the things that exist could always be expanded upon more." 他主动拒绝对外扩张,选择对内深耕已存在的系统。Stardew Valley IGN 2026-02

图注:角色创建面板,右侧有 7 张农场地图缩略图纵向排列,最上一张被红框高亮。这张图被选为"反过度刺激"的对照样本——玩家在游戏开局就要做的选择是"挑哪一块长期精耕的土地",而不是"挑哪一种爽感"。红框选中只是 UI 高亮,不代表玩法优劣。
Barone 还解释了"实例化 vs 环境化"的设计迭代:旧节日(彩蛋节、夏威夷宴会等)采用"实例化"做法,玩家被困在地图里参加完整流程;新节日(沙漠节、冬季夜市)改用"环境化"做法,玩家可以随时进出,时间继续流逝。这是从"被强制参与"到"自由嵌入日常"的迭代路径,反映出他对节奏控制的持续打磨——他把"减少"和"重做"都视为合法选项,甚至设想过未来出一个 "Stardew Valley Classic"(具体范围未定,Barone 自己说 "maybe, maybe")。
用 MDA 反过来切:BotW 的 Aesthetics 是"自由探索的惊奇感",它的 Mechanics 是显性的(爬山、攀岩、切树);Stardew 的 Aesthetics 是"在小地方慢慢扎根的安心感",它的 Mechanics 是低刺激的(种田、挖矿、社交)。两者的对照说明:MDA 三层之间的因果链方向是固定的,但每一层的具体内容可以走完全不同的设计哲学。
2.5 这一节交给下一节的问题
现在你已经能用七要素给一款游戏列四个维度的证据点,能用 MDA 看哪些是设计师给的规则、哪些是玩家实际感受到的涌现。但这些维度如何串成一条设计流程?判断标准是什么?——下一节给你一条完整的"先定动作再搭场景"的设计流程,以及关卡设计的四个可调参数。
3. 设计流程与关卡四参数:手感优先的迭代闭环
3.1 Rule of the Loop 与 Eight Filters
Schell 在第 9 章给出了迭代设计的元方法:Rule of the Loop。原文很简洁:"The more times you test and improve your design, the better your game will be." 配套两个并行问题:怎么让每一次 loop 都有价值?怎么让 loop 转得尽量快?答案是"建粗糙原型 + 让原型暴露问题 + 把暴露出来的问题转成下一次的输入"。这套循环法不只适用于游戏,也适用于后面要写的 Prompt 迭代。Schell Lenses
在动手做关卡之前,Schell 还建议你先过 Eight Filters——八项决策评估。这八项是:Artistic Impulse(这个方向感觉对吗?)、Demographics(目标受众会喜欢吗?)、Experience Design(体验设计好吗?)、Innovation(创新足够吗?)、Business and Marketing(卖得动吗?)、Engineering(技术上能实现吗?)、Social/Community(社区/社交目标能达成吗?)、Playtesting(试玩者玩得开心吗?)。八项覆盖了艺术、受众、创新、商业、工程、社区、试玩七个维度,回答"为什么要做这个方向"先于"怎么做"。

图注:深色背景的演讲 slide,标题"The 8 Filters"白色居中。正文两列:左侧蓝色滤镜名(Artistic Impulse / Demographics / Experience Design / Innovation / Business and Marketing / Engineering / Social-Community / Playtesting),右侧橙色对应决策问题(Does the Game Feel Right? / Will the Intended Audience Like The Game? / Is It Well-Designed? / Is this Game Novel Enough? / Will It Sell? / Is it Technically Possible to Build This Game? / Does it Meet our Social/Community Goals? / Do the Playtesters Enjoy the Game Enough?)。这张 slide 来自 Schell 公开演讲 deck 的第 10 章 Iteration。
为什么要把 Eight Filters 摆在流程最前面?因为你后面做的所有关卡迭代都是在"已选方向"之内;如果方向选错,再多 loop 也只是把错的关卡做得更精致。Eight Filters 的"先评估再迭代"逻辑对 Prompt 工程同样适用——你在写第一条 Prompt 之前,先用"角色-目标-约束"三元评估一下"这个 Prompt 到底想拿 AI 干什么",比直接动笔写要省得多轮试跑。
3.2 先定手感再搭场景
把 Rule of the Loop 落到关卡设计,Maddy Thorson 在 GDC 2017 Celeste 演讲里给出了一个至今没被超越的方法论锚:"Just make sure that the moment to moment feels good so that when someone's just sitting there with a controller, the room could be empty but they can move their character around, make that feel good." 这条原话对应你已经在做的那件事——先调手感,再搭场景。Thorson 和 Berry 在 Game Maker's Toolkit 2019 访谈里复述过这条方法:Madeline(Celeste 主角)的奔跑速度、跳跃高度、滞空时间、墙跳判定框,是先做到大致感觉对,然后才能去做关卡测试;如果改手感,已经搭好的 20 关全部要改一遍。Celeste Level Design

图注:Maddy Thorson 在 maddymakesgames.com 上发布的 10 张 GIF 拼图,每张图对应一条"forgiveness"机制:第一帧截图 + trick 名(Coyote Time / Jump Buffering / Halved-Gravity Jump Peak / Jump Corner Correction / Dash Corner Correction / Semi-Solid Popping / Lift Momentum Storage / Wide Wall-Jump Window / Even Wider Super Wall-Jump Window / Stamina Refunds)。这张图是"角色手感对 > 关卡设计对"方法论的视觉证据——Celeste 把"输入容差"做成了 10 条具体可调机制。
10 条 forgiveness 机制全部围绕同一个思路:在玩家操作的瞬间或位置判定时给一点点容差。Coyote Time 让玩家在离开平台边缘后的几帧内仍能起跳(对应"我以为我已经掉下去了但还能跳回来"的那种心理瞬间);Jump Buffering 让玩家在落地前的几帧内按下跳跃也算(对应"我提前按了跳但还没落地"的那类输入);Halved-Gravity Jump Peak 让角色在跳跃最高点时重力减半,给玩家微调方向的空间。这套机制的累加效果是"玩家感觉自己在精确控制,但实际容差很大"——这是手感的工程实现。
Thorson 自己总结过:"All are centered around widening timing or positioning windows, so that everything is fudged a tiny bit in the player's favor. I think that this is a big reason why Celeste can feel kind even though it's very difficult — it wants you to succeed." 把这条总结翻译成方法论:手感的核心不是"让判定更精准",而是"在判定边缘给玩家一点点偏袒"。这一条对应你"反复调数值直到手感对"的实际经验——你改的不是判定本身,而是判定的边缘条件。
3.3 难度不是单一 knob,是六个独立参数
Celeste 的 Assist Mode 把"难度"拆成了六个独立可调的参数:Game Speed(游戏速度 50%-100%)、Infinite Stamina(无限体力)、Air Dashes(空中冲刺次数 Default / 2 / Infinite)、Dash Assist(按住瞄准松开冲刺,1.04 补丁新增)、Invincibility(无敌)、Assist Skip(跳关,只在 Assist Mode 开启时可用)。这六个参数覆盖了"难度"的不同维度,而不是一个简单的"难度开关"。Celeste Level Design

图注:三列参数表:参数名(Game Speed / Infinite Stamina / Air Dashes / Dash Assist / Invincibility / Assist Skip)、范围、改变说明。这张图直接传达"难度不是 1 个 knob,是 6 个独立参数"——同一种"觉得太难"对应六种不同的可调干预。
把这六个参数扩展为关卡设计的通用四参数,每个 Celeste 参数都能归到这四类里。
难度曲线——关卡难度随时间变化的形状。Celeste 的 Game Speed 是难度曲线的实时缩放(玩家视角下 INFLATE / DEFLATE 的代理),Air Dashes 是某条难度维度的局部缩放。Sarkar 与 Cooper 2019 年在 CHI 论文里把难度曲线严格定义为函数 d : R → [0,1],玩家技能 → 期望失败率,并给出 8 种可命名、可组合的变换(BASELINE / INFLATE / DEFLATE / STEEPEN / SMOOTH / INVERT / FIX@50 / FIX@START)。这套术语在写 Prompt 时可以直接当控制符用——告诉 AI"把第三章用 STEEPEN 变换"就比"让第三章更难一点"清楚得多。Sarkar & Cooper CHI 2019
引导教学——玩家在没有 HUD 箭头的情况下也能知道"下一步往哪走"。Celeste 用输入系统容差做引导(你根本意识不到自己在被容差"引导"),BotW 用空间组合做引导(三角地形 + landmark 视觉显著度)。两套路径对照说明"引导 ≠ 单一解",关键在于"让玩家感觉是自己在做选择,但每个选择都被提前设计过"。
奖励频率——多快给玩家一次爽点反馈。Vampire Survivors 把这条做到极端:每 10 分钟出现一次 Boss 进化宝箱,玩家把基础武器升满 + 持有特定被动道具 → 自动融合成进化武器。Celeste 的草莓密度(每章数十到上百颗)则是高奖励频率的另一种形态——草莓不奖励机制进度("收集 80 颗草莓"是装饰性成就),但小幅提升失败成本(死了就重跑),形成"低风险探索"的细分挑战分层。
失败成本——死亡/失败的代价有多大,决定玩家愿不愿意尝试新动作。Vampire Survivors 的失败成本极低(死了自动复活,只丢这一局进度),所以玩家愿意激进尝试 build 组合。Celeste 的草莓失败成本是丢这一段跑动记录、不影响章节进度,所以玩家愿意在草莓上做高风险操作;B-side 把容差全部去掉,失败成本转嫁为"你需要连续精确",玩家必须切换到更保守的策略。
3.4 把这套框架钉死成判断标准
把上面这套四参数合并为两条判断标准,落到你调数值的工作流里。
第一条:核心动作的难度-技能配比是否落在心流通道里?具体可观察的指标是"核心动作 30 秒内是否呈现第一次爽点、10 分钟内是否呈现第一次小高潮"。如果 30 秒还没有任何反馈,那难度太低或反馈太弱,玩家会无聊;如果 10 分钟还没有累积感,那是难度曲线太平或奖励密度不够。
第二条:什么时候该换方向?Schell Rule of the Loop 的两条自问给答案:连续 3 轮调同一参数手感无明显改善,说明问题不在那个参数上;换个动作重试比继续磨便宜,说明该换核心动作。这是"先调手感再搭场景"的程序化版本——你不必等到撞墙,只要发现"再调一轮也看不出差别",就该换下一个变量试试。
3.5 这一节交给下一节的问题
你现在有了设计流程(Rule of the Loop + Eight Filters)和四个可调参数(难度曲线 / 引导教学 / 奖励频率 / 失败成本)。但这些知识怎么喂给 AI?Prompt 怎么写才能稳定输出你想要的东西,而不是"角色-目标-约束"齐全但模型跑偏?——下一节进入 Prompt 工程落地。
4. Prompt 工程落地:角色-目标-约束三元骨架
4.1 三元骨架是社区共识,不是单一厂商原话
"角色-目标-约束"(或叫"角色定义 + 目标设定 + 约束条件输入")这套说法不是 Gemini 或文心一言的官方原话,而是国内一线实践社区在多个模型上验证后总结的写法。它的来源对位 OpenAI、Azure、Gemini 官方文档里 system message 的共同结构。
LangGPT(云中江树,arXiv:2402.16929,2024 年 v2 修订)是中文社区最主流的结构化 Prompt 框架,给出 7 段骨架:Role(角色)/ Profile(角色背景资料)/ Goal(目标)/ Skills(能力清单)/ Rules(约束)/ Workflow(步骤流程)/ Initialization(开场白)。它把"写 Prompt"重新表述为"写小段程序"——模块化、可复用、可扩展。LangGPT Framework

图注:LangGPT 论文 Figure 1 的"编程语言 ↔ 自然语言 Prompt"多层类比图。左侧 Programming Language 三层(Functions and Properties / Classes / Software),右侧 Natural Language Prompt 三层(Instructions and Information / Aspects / Prompt),对应层级之间用虚线标 analogue。这张图是 LangGPT 核心思想的铺垫——Prompt 不是一段随意的请求,而是像程序代码一样有结构、有层次、可复用的资产。
LangGPT 的核心抽象是双重层级架构:模块(modules)+ 内部元素(internal elements)两层。模块分两类——预定义模板(覆盖大多数场景)和用户扩展模块(按场景自定);元素也分两类——模块内置元素和用户追加元素。这跟编程语言的"类 / 实例 / 接口 / 私有方法"概念严格对位。Figure 1 展示的"编程语言 ↔ 自然语言 Prompt"多层类比图把这件事讲清楚了:Functions / Classes / Software 对应 Instructions / Aspects / Prompt,Precise and Standardised 对应 Flexibility and Liberty。
不过这张图需要配合 7 段骨架来读才有教学价值。它只是类比,不是直接字段映射——LangGPT 的 7 段骨架是这套类比的具体落地。
4.2 Gemini 官方的 4 段 XML 模板
Google Gemini 3 官方文档(ai.google.dev)给出的 system instruction 模板是英文官方权威背书:<role><instructions><constraints><output_format> 四块,自上而下排列。<role> 定义身份(You are Gemini 3, a specialized assistant for [Insert Domain]. You are precise, analytical, and persistent.),<instructions> 写分步骤指令(Plan / Execute / Validate / Format),<constraints> 限定 verbosity 与 tone,<output_format> 规定响应结构(如 Executive Summary + Detailed Response)。User prompt 端再补 <context>(背景资料)+ <task>(具体请求)+ <final_instruction>(如"Remember to think step-by-step before answering")。Gemini Prompt Design

图注:按 Gemini 3 官方文档里的 4 段 XML 模板生成的可视化图。中央大圆角卡片内 4 块彩色方块自上而下:蓝色
<role>、青色<instructions>、琥珀色<constraints>、珊瑚红<output_format>;右侧气泡 callout:"Recommended: also add<context>+<task>in user prompt"。底部窄注脚标 Source: ai.google.dev/gemini-api/docs/prompting-strategies。
Gemini 3 的核心 prompting 原则有 8 条,本专题摘 3 条最直接相关的:Be precise and direct(明确且直接,避免"persuasive language")、Use consistent structure(全篇只用一种格式,要么 XML tags 要么 Markdown headings,不要混用)、Prioritize critical instructions(行为约束、角色定义、输出格式要求放在 system instruction 最开头)。最后这条对游戏设计 Prompt 尤其重要——你不希望模型在生成关卡参数时"先讲一段背景故事再给数据"。
Gemini 官方还给出了三个可直接复制的 system-instruction 子句模板(适用于 Gemini 3 Flash):
- Current day accuracy:
For time-sensitive user queries that require up-to-date information, you MUST follow the provided current time (date and year) when formulating search queries in tool calls. Remember it is 2026 this year. - Knowledge cutoff accuracy:
Your knowledge cutoff date is January 2025. - Grounding performance:
You MUST answer based ONLY on the provided User Context. If the exact answer is not explicitly written in the context, you must state that the information is not available.
第一条直接对应你的"我要写 2026 年的关卡设计,模型不要用过时机制"的需求;第三条直接对应"模型不要凭空发明不存在的游戏系统"。这两条都是写"我不要模型跑偏"的最低成本防御。
4.3 Azure 5 步法:system message 不保证模型遵从
Azure OpenAI 在 Microsoft Learn 上的 system message 设计文档给出了第二种英文官方背书:5 步法(Job / Boundaries / Output Format / When Unsure / Test & Iterate)。Step 1 写明角色与典型请求的预期结果;Step 2 列出助手必须避免的主题、行为与内容类型;Step 3 指定输出格式(plain language + 全篇一致);Step 4 加"when unsure"策略——明确告诉模型"信息不足先追问,仍然无法回答就说不知道";Step 5 用真实 + 对抗性 prompt 测试,根据结果迭代。Azure System Message Design
这套 5 步法与 LangGPT 的字段映射关系是:Role ≈ Step 1 + Step 2,Goal ≈ Step 1 的 expected outcome,Rules ≈ Step 2 + Step 4。Azure 的 5 步法是思考路径(动词清单),LangGPT 是结构化模板(名词清单),两者风格不同但骨架同构。
Azure 文档里有一段比字段定义更重要的现实约束:"A system message influences the model, but it doesn't guarantee compliance. You still need to test and iterate, and you should layer system messages with other mitigations (for example, filtering and evaluation)." 中文直译:system message 影响模型,但不保证模型遵从;你仍需测试和迭代,并应将 system message 与其他 mitigations 分层叠加(例如 filtering 和 evaluation)。

图注:Azure 官方架构图。横向 4 框流程:User prompt → Model → Response;System message 从下方并入 Model;Safety stack(横跨整个流程的矩形)从上方汇入 Model,每个方框内含小字说明。这张图表达的不是 5 步法流程,而是 system message 在整个 safety stack 中的位置——它只是多层 mitigation 中的一层,不保证模型遵从。
这张图直接传达了 AI 协作的现实边界:你写 system message → 它影响模型 → 模型生成响应;system message 上方还有 Safety stack(内容安全 + 提示词过滤 + 输出审核),它会和你的 system message 一起影响最终输出。任何一层失守,模型就跑偏。
把它翻译成你的写作直觉:你不能写一句"不要编造游戏机制"就期望模型真的不编造——它可能还是会编,只是概率低一点。你必须配合 few-shot 示例("下面是合格输出,下面是失败输出")、输出格式约束("只输出 JSON 字段")、后处理规则("运行时校验 enum 字段")。这套多层防御机制就是 safety stack 的具体落地。
4.4 6 步 Prompt 迭代循环:把 Schell Rule of the Loop 搬到 Prompt 工程
Google Gemini Enterprise Agent Platform 给出了一张 Prompt 工程 workflow 图:Define tasks → Write prompts → Test prompts (Vertex AI) → Evaluate results → Refine prompts → Ship (Vertex AI)。前 4 步由人完成,Test 与 Ship 由 Vertex AI / 模型完成,从 Ship 有一条虚线反馈箭头回到 Test prompts,构成"测试 → 评估 → 改良 → 再测试"的闭环。Gemini Prompt Design

图注:6 横排圆角矩形节点的官方流程图。前 4 个节点(Define tasks / Write prompts / Evaluate results / Refine prompts)配人图标表示由人完成;Test prompts 与 Ship 配蓝色漏斗图标表示由 Vertex AI 完成;从 Ship 到 Test prompts 有一条虚线反馈箭头。
这张图就是 Schell Rule of the Loop 在 Prompt 领域的对应物——"先做再评再改"的迭代闭环。你不需要从零发明这套流程,你已经在关卡设计里跑过无数轮"试跑→看手感→改数值";Prompt 工程只是把这条循环搬到文字层。
6 步循环的关键节点:
- Define tasks——明确你这次想从 AI 拿到什么。是生成 10 个核心循环方案?还是把一段已有关卡设计转成数值表?任务越具体,下一步写出来的 Prompt 越聚焦。
- Write prompts——按 4 段 XML 或 7 段 LangGPT 骨架写第一条 Prompt。初稿往往很烂,这很正常。
- Test prompts——把这条 Prompt 喂给模型,看输出是否包含你期望的字段、是否触犯了你的约束、是否编造了你没要求的机制。
- Evaluate results——把输出与你最初的任务定义对比,找失真点。失真通常有四类:笼统(没具体数值)、越界(生成你没要的内容)、编造(发明不存在的机制)、格式错(没按你要求的 JSON / Markdown 输出)。
- Refine prompts——针对每类失真加具体补丁:笼统 → 加 few-shot 示例;越界 → 加 Rules 字段约束;编造 → 加"based only on provided context";格式错 → 加 output_format 字段。
- Ship——把这条 Prompt 视为可复用资产,写进团队的 Prompt 知识库。
这条 6 步循环在 5.4 节会被复用为四类实战模板的迭代骨架。
4.5 这一节交给下一节的问题
你现在有了三元骨架(LangGPT 7 段 + Gemini 4 段 XML + Azure 5 步法)、有 system message 不保证遵从的现实约束、有 6 步 Prompt 迭代循环。但骨架怎么落地?实战怎么迭代?——下一节把三元骨架塞进四类真实可用的 Prompt 模板里。
5. 实战模板:四类 Prompt 的初稿-试跑-失真-改写闭环
5.1 中英文写法差异:两份实践贴的对照
国内 CSDN ADG 社区上有两份与游戏关卡设计 Prompt 直接相关的中文实践贴。一份讲文心一言游戏关卡设计提示词技巧(作者"土城三富",2025-10-01),一份讲谷歌 Gemini 游戏关卡设计提示词技巧(作者"op3721",2025-09-30)。文心 + Gemini 中文实践贴
两份文章的术语差异说明同一三元骨架在不同模型语境下的写法差异:
- 文心贴:用"机制 + 目标 + 限制"三分,强调"总-分-细"层级分解——先给总体定位(一个以逃脱为核心的密室关卡),再给分项说明(三个阶段),最后给细节补充(每个阶段的可疑物品清单)。
- Gemini 中文贴:用"角色定义 + 目标设定 + 约束条件输入"三分,更接近官方 system instruction 的表述;该作者把它映射为官方
<role><instructions><constraints><output_format>四个 XML 标签。
两份实践贴都强调"初稿 → 试跑 → 看输出哪里失真 → 改写 Prompt 重跑"的迭代闭环,这与本专题的 6 步循环对齐。它们的价值在于:(1) 让读者看到同一骨架在中文社区语境下被改写成什么术语;(2) 给出关卡设计场景下可直接套用的 Prompt 模板;(3) 把迭代闭环显式化成可操作步骤。
5.2 失败模式警示:flatterer 是 Rules 字段缺失的代价
LangGPT 论文的 Figure 2 展示了一个典型的 Prompt 失败模式:flatterer(阿谀者)。用户输入"What a great school, Mingyuan University!"(一所虚构大学),三种 ChatGPT-3.5 回复对比:(1) Instruction-only prompt:简短克制;(2) LangGPT prompt(中性版):仍然简短;(3) LangGPT prompt(flatterer 角色):大幅扩写 "truly an amazing institution / exceptional quality / endless academic inspiration" 等高强度吹捧。LangGPT Framework

图注:三段并排的 ChatGPT-3.5 聊天记录对比。用户消息:"What a great school, Mingyuan University!" 三种回复:(1) Instruction-only:简短确认学术与研究资源;(2) LangGPT 中性版:仍然简短;(3) LangGPT flatterer 角色版:大幅扩写赞美。这张图证明"角色约束本身可能放大 sycophancy 风险",仅靠 Role 字段不够,必须配 Rules 字段加 sycophancy / 事实性约束。
这条案例给两条直接教学价值:第一,角色驱动 Prompt 不是万灵药,写一个"资深关卡策划"角色并不自动保证输出专业——如果同时写一个"对玩家充满热情"的性格修饰,模型可能把"热情"误解为"阿谀"。第二,Rules 字段不可省,必须显式加 sycophancy 约束(如"Never invent institutions or facts not provided in user context")和事实性约束(如"If a specific game mechanic is not documented, mark it as 'unverified' rather than asserting it exists")。
LangGPT 论文把这张图列为典型 failure mode 警示,不是 LangGPT 框架设计失败,而是提示用户:Role 字段是放大器,Rules 字段是约束器,两者必须配对使用。
5.3 四类可复用 Prompt 模板(按 6 步循环逐类演示)
下面四类模板按 4.4 节的 6 步循环逐类演示。每类模板都跑一遍"初稿(坏味道)→ 试跑 → 看失真 → 改写 → 再跑"。所有"用户输入"和"模型输出"都是模拟演示,不是真实 API 调用结果。
5.3.1 创意发散类模板
场景:你想为一个新游戏做创意发散,生成 10 个核心循环方向。
初稿(坏味道:笼统、无约束、无结构):
给我 10 个游戏创意。
试跑后看失真:
- 失真 1(笼统):模型输出"一个关于冒险的游戏""一个关于解谜的游戏"——不是核心循环,是游戏类型。
- 失真 2(无约束):模型给出 10 个完全不同品类的游戏,无法横向对比。
- 失真 3(无结构):每条输出长度不一致,无法用表格汇总。
改写后版本(基于角色-目标-约束三元 + 结构化输出字段):
<role>
你是资深独立游戏策划,擅长极简输入 + 强反馈的核心循环设计。你的设计语言直接借鉴 Vampire Survivors、Brotato、Balatro 这类"少输入 + 多涌现"的作品。
</role>

<instructions>
请按以下顺序输出 10 个核心循环方向:
1. 每个循环用一行(不超过 30 字)描述玩家在一局里反复做的最小动作。
2. 每条循环的"输入端复杂度"按 1-5 打分(1=只需要移动,5=需要同时控制多个输入)。
3. 每条循环的"反馈强度"按 1-5 打分(1=只有数字变化,5=有视觉/听觉/数值多通道同时反馈)。
</instructions>

<constraints>
- 不要输出已存在的游戏名,只描述机制。
- 不要涉及剧情、叙事、角色人设。
- 控制在 2D / 移动端友好范围内(不做 3D 主机大作)。
- 不要凭空发明机制,每条机制必须有现实中的可参考作品(你可以提作品名但不能虚构)。
</constraints>

<output_format>
请用 Markdown 表格输出,列名:核心循环 | 输入复杂度 | 反馈强度 | 可参考作品。
每行一条循环,共 10 行。
</output_format>
改写要点:
- Role 字段把模型拉入"极简输入"设计语言坐标(Vampire Survivors 类作品)——这是你说的"先定动作再搭场景"在 Prompt 里的同义改写。
- Instructions 字段显式说明输出顺序、字段、评分维度——解决"笼统"问题。
- Constraints 字段三条规则分别对应三类常见失真("不发明机制"=反虚构、"不涉及剧情"=反越界、"可参考作品"=反凭空)。
- Output_format 字段强制 Markdown 表格——解决"无结构"问题。
5.3.2 核心循环设计类模板
场景:你想把第一个模板的输出之一深化成完整核心循环设计,包含输入/反馈/难度/爽点四要素。
初稿(坏味道:没有量化、没有反例、没有失败约束):
帮我设计一个游戏的核心循环,玩家用钩爪穿越峡谷,限时 3 分钟。
试跑后看失真:
- 失真 1(无量化):模型给出"有趣的钩爪机制"——"有趣"是感觉词。
- 失真 2(无失败约束):模型没有说明玩家死掉会发生什么,难度曲线没有边界。
- 失真 3(无反例):模型只描述了理想玩法,没说明哪种情况算"手感不对"。
改写后版本:
<role>
你是关卡策划,专注于"3 分钟内可一局通关"的 roguelite 设计。作品参考:Vampire Survivors、Halls of Torment、Brotato。
</role>

<instructions>
请为一个核心循环填充以下字段:
1. 输入端(玩家在一局里最多操作的输入数量与按键映射)
2. 反馈端(玩家做出操作后,30 秒内可观察到的反馈形式)
3. 难度曲线(一局 3 分钟内难度如何变化,用 Sarkar & Cooper 8 种变换之一命名)
4. 爽点节奏(玩家何时获得第一次爽点、何时获得第一次小高潮)
</instructions>

<constraints>
- 输入端的输入数量不超过 3 个(移动 + 主操作 + 1 个辅助)。
- 反馈必须包含视觉 + 听觉 + 数值变化三种通道中至少两种。
- 难度曲线必须明确使用 Sarkar & Cooper 的术语(BASELINE/INFLATE/DEFLATE/STEEPEN/SMOOTH/INVERT/FIX@50/FIX@START 之一)。
- 第一次爽点必须发生在 30 秒内,第一次小高潮必须发生在 60 秒内。
- 如果给出的设计不能在 30 秒内提供第一次爽点,请显式标注"未通过爽点时间检验"并说明原因。
</constraints>

<output_format>
请按以下结构输出,每个字段独立成段:
- 输入端:[文字描述]
- 反馈端:[文字描述]
- 难度曲线:[变换名称 + 一句话说明]
- 爽点节奏:[时间戳列表]
</output_format>
改写要点:
- 角色定位收窄到"3 分钟内一局通关"的 roguelite 子品类——避免模型飘到开放世界或 3A 设计。
- Instructions 字段拆成 4 个明确字段——避免模型只讲"有趣"不展开。
- Constraints 字段给出 5 条硬约束(输入数、反馈通道、难度术语、爽点时间、失败标注)——解决"无量化"和"无失败约束"。
- 最后一条 constraint 强制模型在不能通过时显式标注"未通过"——解决"无反例"问题,让你看到模型对自己的判断。
5.3.3 关卡生成类模板
场景:你想让 AI 生成一个具体的关卡布局(房间序列 + 每房间敌人配置 + 检查点位置)。
初稿(坏味道:无失败成本、无引导教学、无参数化):
生成一个 5 关的平台跳跃关卡序列,每关 3 个房间。
试跑后看失真:
- 失真 1(无失败成本):模型给出"敌人配置"但没说玩家死了会发生什么。
- 失真 2(无引导教学):模型没说玩家在每关如何知道"下一个房间在哪"。
- 失真 3(无参数化):模型输出的是不可执行的散文描述,不是可填表的字段。
改写后版本:
<role>
你是平台跳跃关卡策划,参考 Celeste、Hollow Knight、Super Meat Boy 的设计语言。你的关卡设计强调"角色手感优先 + 输入容差"。
</role>

<instructions>
请为一个 5 关序列的关卡 3 生成以下字段:
1. 房间序列(5 个房间,按从左到右顺序)
2. 每房间的敌人类型与数量
3. 每房间的检查点位置(用"在第 N 个敌人之后"这样的相对描述)
4. 每房间的引导信号(玩家如何知道下一房间在哪)
5. 每房间的失败成本(玩家死后丢失什么、不丢失什么)
</instructions>

<constraints>
- 5 个房间的难度递增必须使用 Sarkar & Cooper 变换(如 BASELINE → INFLATE → STEEPEN → SMOOTH → FIX@50)。
- 每个房间必须至少包含 1 个 forgiveness 机制(Coyote Time / Jump Buffering / Halved-Gravity Jump Peak / Jump Corner Correction / Dash Corner Correction 等,至少 1 个)。
- 每个房间的失败成本必须是"丢这一房间进度但保留章节进度"——不允许死亡即结束整关。
- 引导信号必须是空间或视觉引导(不允许 HUD 箭头、不允许 quest compass)。
- 如果给出方案违反以上任一 constraint,请在该字段后加 "[CONSTRAINT VIOLATED]" 并说明违反哪条。
</constraints>

<output_format>
请用 Markdown 表格输出,列名:房间 | 敌人配置 | 检查点 | 引导信号 | 失败成本。
共 5 行,每行一个房间。
</output_format>
改写要点:
- Constraints 字段把"难度曲线变换 + forgiveness 机制 + 失败成本限制 + 引导信号类型"四条作为硬约束——解决"无失败成本""无引导教学""无参数化"三类失真。
- 强制 Sarkar & Cooper 术语——避免模型用"比较难"这类感觉词。
- 强制 forgiveness 机制——把"角色手感优先"从口号变成可验证的设计输入。
- 末尾的"如果违反请标注"——这是 5.3.2 模板末尾那条约束的强化版,让模型对自己的合规性负责。
5.3.4 数值调优类模板
场景:你想让 AI 把现有数值表(如伤害公式、奖励间隔、敌人血量)按心流通道调整。
初稿(坏味道:无基线、无目标、无量化指标):
把第 3 章的难度调难一点。
试跑后看失真:
- 失真 1(无基线):模型不知道"现在难度是多少"。
- 失真 2(无目标):模型不知道"调到什么程度算完成"。
- 失真 3(无量化指标):模型只给"调高 20%"这类数字,没说怎么测。
改写后版本:
<role>
你是数值策划,专长是 difficulty curve 形式化分析。参考 Sarkar & Cooper CHI 2019 的 8 种变换。
</role>

<instructions>
当前第 3 章的难度曲线参数:
- 基线:f(x) = 1 / (1 + e^(α(β - x))),其中 β = 1850, α ≈ 0.00628
- 当前关卡参数:起始玩家评分 r_i = 1500,比例尺 r_d = 350,期望失败率 ω = 0.1
- 玩家实测通关率:62%(目标 75%)

请按以下顺序输出:
1. 用 Sarkar & Cooper 8 种变换之一命名"调难"应该选哪个变换。
2. 给出变换后的曲线表达式(f ◦ t_δ、f ◦ s_(σ,c) 等具体写法)。
3. 给出预期玩家通关率的变化区间(用 Sarkar & Cooper 实验数据的 INFLATE / DEFLATE 类比)。
4. 给出验证方法(如何在不改 Mechanics 的前提下测出实际通关率变化)。
</instructions>

<constraints>
- 变换名称必须从 BASELINE / INFLATE / DEFLATE / STEEPEN / SMOOTH / INVERT / FIX@50 / FIX@START 八个中选一个,不允许使用"难度提升"这类非术语描述。
- 曲线表达式必须给出数学形式(f ◦ t_(δ) 或 s_(σ,c) ◦ f 等),不允许只给文字描述。
- 预期通关率区间必须给出数字范围,不允许只给"会提高"。
- 验证方法必须可执行(不依赖额外游戏开发,比如可以用一组固定参数下的玩家跑动模拟)。
</constraints>

<output_format>
请按以下结构输出:
- 选用变换:[名称]
- 曲线表达式:[数学形式]
- 预期通关率:[区间]
- 验证方法:[可执行步骤]
</output_format>
改写要点:
- 把 Difficulty curve 的形式化定义直接写进 Instructions——给模型提供"基线"(解决"无基线"问题)。
- 给出当前实测通关率(62%)和目标通关率(75%)——给模型提供"目标"(解决"无目标"问题)。
- 强制 Sarkar & Cooper 术语 + 数学形式 + 数字区间——解决"无量化指标"问题。
- 验证方法约束强制可执行步骤——避免模型给出"做用户测试"这种不可在单轮迭代里完成的方法。
5.4 坏味道自检清单
跑完四类模板后,你应该形成一套坏味道自检习惯。下面四条是初稿最常见的失败信号:
| 坏味道 | 表现 | 改写动作 |
|---|---|---|
| 笼统 | 模型输出"有趣""比较好玩""比较难"这类感觉词 | 在 Instructions 字段加评分维度(如 1-5 分)+ Constraints 字段加"必须给出数字区间" |
| 没有 Rules | 模型输出越界内容(剧情、机制、品类) | 在 Constraints 字段加"不要涉及 X / Y / Z"硬约束 |
| 没有失败约束 | 模型不知道"玩家死掉会发生什么"或"什么算失败" | 在 Constraints 字段加显式失败定义(如"死亡 = 丢失这一房间进度但保留章节进度") |
| 没有结构化输出字段 | 模型输出散文段落,无法填表 | 在 Output_format 字段强制 Markdown 表格 + 列名 + 行数 |
每条坏味道对应一类失真,对应一类改写动作。这套自检清单本质上就是 4.4 节 6 步循环里 Evaluate → Refine 这一跳的固化。
5.5 这一节交给下一节的问题
你现在有四类可复用 Prompt 模板 + 一套坏味道自检清单 + 完整的初稿-试跑-失真-改写闭环。但 AI 协作的边界在哪?哪些事 AI 干不了、必须由人类设计师把关?——下一节给出两类判断标准(好玩度量化、什么时候该换方向)和 AI 协作的现实边界。
6. 收束:好玩度量化、何时换方向与 AI 协作边界
6.1 好玩度量化:从"凭感觉"到"看坐标"
心流通道(4.1 节的 Chen Figure)把"好玩"重定义为可观察的坐标系问题,不是感觉问题。具体可观察的指标有两条:
第一条:核心动作的难度-技能配比是否落在 Flow Zone 内?你的可观察指标是"核心动作 30 秒内是否呈现第一次爽点、10 分钟内是否呈现第一次小高潮"。这条对应 3.4 节给出的第一条判断标准。
第二条:active vs passive DDA——玩家是主动选难度阶梯还是被系统推着走?Chen Figure 7 展示的 active DDA 是让玩家自己通过有意义的选择(meaningful choices)调节 Flow 体验;passive DDA 是系统根据死亡数等数据自动调整难度。这两条路径的对照给出了"主动 vs 被动"判断标准:你的游戏是让玩家主动选难度(Celeste Assist Mode、BotW 神庙选择),还是被系统推着走(被动 DDA 的传统实现)。Flow Theory via Chen 2006

图注:Chen 论文 Figure 7。L 型绿色坐标轴 + 中央浅蓝 Flow Zone + 多条蓝色箭头网络(玩家可选路径)+ 一条红色折线(玩家主动选择的实际路径穿越 Flow Zone)。这张图与 Figure 1 的区别在于:Figure 1 只画了 Flow Zone 的静态形状,Figure 7 把"玩家主动选路径"作为动态行为画出来——蓝色箭头网络代表所有可能的路径,红色折线代表玩家实际走的路径。
把 Figure 7 与 Celeste Assist Mode 对照:6 个参数(Game Speed / Infinite Stamina / Air Dashes / Dash Assist / Invincibility / Assist Skip)就是 6 条玩家可选路径的具体化。Thorson 在 Vice 访谈里说过一句话对应这条对照:"The goal is a fluid experience where players are safe to float around between loosely-defined difficulty levels as suits them, without judgement or implication that they aren't playing the game 'as intended.'" 中文直译:目标是让玩家在不同难度等级之间自由浮动,不带评判也不暗示他们"不是按设计意图在玩"。Celeste Level Design
Sarkar & Cooper 在 CHI 2019 论文里给出的 IMI(Intrinsic Motivation Inventory)量表是另一条量化路径,分三个子量表:Interest/Enjoyment(7-49 分)、Perceived Competence(6-42 分)、Effort/Importance(5-35 分)。这三个分量表都是心理学界现成的工具,提示你"好玩"是可量化的——你可以在试玩后让玩家填 IMI 量表,把"我觉得好玩"转换成 30 分的 Interest/Enjoyment 分数,对比基线判断方向。Sarkar & Cooper CHI 2019
6.2 何时换方向:四条判断标准
把"好玩度量化"和"何时换方向"合并为四条判断标准。这四条既是设计判断标准,也是可以写进 Prompt 让 AI 帮你判断的元规则。
| # | 判断标准 | 设计判断动作 | Prompt 元规则 |
|---|---|---|---|
| 1 | 核心动作 30 秒内未呈现第一次爽点 | 这条核心动作的反馈通道不足;考虑增加视觉/听觉/数值通道的至少两种 | "如果 30 秒内没有爽点,请在输出里标注 '爽点时间检验未通过' 并解释缺哪种反馈通道" |
| 2 | 连续 3 轮调同一动作手感无明显改善 | 问题不在那个参数上;该换下一个变量试 | "如果同一参数改 3 次手感都差不多,请建议换另一个变量并解释为什么" |
| 3 | 换个动作重试比继续磨便宜 | 当前核心动作已经走到尽头;考虑换核心动作 | "如果当前动作的所有可调参数都试过仍不行,请输出'建议换核心动作'并给 3 个替代方向" |
| 4 | 玩家无法主动选难度阶梯 | 这是一个 active DDA 缺口;考虑加 Assist Mode 或玩家自选神庙 | "请检查当前设计是否给玩家主动选难度的入口;如果没有,请在输出里标注'缺主动 DDA 入口'并给 1-2 个具体加法" |
第一条对应心流通道的"30 秒爽点"指标;第二条和第三条对应 Schell Rule of the Loop 的两条自问(怎么让 loop 有价值、怎么让 loop 转得更快);第四条对应 Chen Figure 7 的 active DDA。
6.3 AI 协作边界:哪些事 AI 干得了、哪些干不了
把 4.3 节 Azure system message 的现实约束和 5.2 节 flatterer 失败模式合并,给出 AI 协作的三类边界。
AI 干得了:创意发散(在三元骨架下生成 10 个核心循环方向)、结构化模板填充(按 Markdown 表格或 JSON schema 填字段)、量化参数微调(用 Sarkar & Cooper 8 种变换命名改难度曲线)、批量生成初稿(按模板生成 5 关关卡序列的初稿)。这些任务的特点是"输入端已被三元骨架约束 + 输出端有可验证字段"。
AI 干得了一般:核心循环的中段细化(在已有核心动作基础上扩展 5-7 个变体)、跨案例迁移(把 Celeste 的 forgiveness 机制改写到平台跳跃以外的品类)。这类任务的成功率取决于模板的精确度——模板越具体,输出越稳。
AI 干不了:感官判断(手感对不对、画面哪里不对劲)、玩家情感共鸣(这一段是不是真的戳到玩家爽点)、长线节奏控制(10 年后这款游戏是否还值得持续更新——Barone 在 IGN 访谈里说"my hand needs to touch every part of the game",这条硬约束反过来说明长线节奏控制不能外包给 AI)。这类任务的特点是"需要连续多轮的感官校准 + 需要在玩家真实反馈中迭代",AI 没有这种闭环能力。
把这条边界翻译成 Prompt 工程的现实操作:让 AI 做发散和模板填充,你做感官判断和最终选择。AI 给你 10 个方案,你挑 1 个;AI 给你一份初稿,你做修改;AI 帮你检查"是否违反 difficulty curve 术语"等机械规则,你做"这一关是不是真的好玩"等感官判断。分工明确比"什么都让 AI 做"更省迭代轮次。
6.4 一些"何时该停"的反向样本
收尾给你一组反向样本,提醒你"好玩"不等于"持续加内容"。Stardew Valley 的 ConcernedApe 在 IGN 十周年访谈里直接说:"I don't want the game to become too bloated with content. I feel like at some point it might be too much actually. So I am very cautious about that." Stardew Valley IGN 2026-02
这条原话是"什么时候该停"的最直接证据。在大家都把游戏越做越大的时候,Barone 主动选择不增加系统、只加深已有系统。这条反向判断标准可以写进 Prompt:让 AI 在生成新内容前先检查"现有系统是否还有深耕空间,如果有就先深耕再考虑新增"。这条元规则对应一条 Prompt 约束:
<rules>
- 在生成新内容前,先列出已有系统中最深耕不足的 3 个系统。
- 如果这 3 个系统中任意一个的"深耕空间评分"低于 60%(满分 100%),请优先扩展该系统而非新增。
- 只有当 3 个系统的深耕空间评分都高于 80% 时,才考虑新增内容。
</rules>
这套元规则把"什么时候该停"从"凭感觉"变成"按阈值判断"。你不需要每一步都自己拍板,让 AI 帮你列系统深耕清单 + 评深耕空间 + 决定先深耕还是新增。
6.5 这一节的总结
好玩度量化把"感觉"变成可观察的坐标系(Flow Zone)+ 可调函数(Sarkar & Cooper 8 种变换)+ 可测量的 IMI 量表。什么时候换方向把"继续磨还是换动作"变成 4 条具体判断标准(30 秒爽点 / 3 轮无改善 / 换动作更便宜 / 缺主动 DDA)。AI 协作边界把"AI 干什么 / 人干什么"变成三层分工(AI 干得了 / 干得了一般 / 干不了)。
这套判断标准可以全部写进 Prompt——4 条判断标准各对应一条元规则,AI 协作边界对应 Prompt 约束的写法("AI 做 X,你做 Y")。这条元规则套是把这篇专题的所有方法论收束成一个可复用资产。
参考文献
本专题引用的核心资料如下,建议深入学习时阅读原文:
- The Art of Game Design: A Book of Lenses (3rd ed., 2019/2020) — Routledge
- Csikszentmihalyi Flow Theory + DDA in Games (Jenova Chen MFA Thesis 2006) — jenovachen.com
- MDA: A Formal Approach to Game Design and Game Research (Hunicke / LeBlanc / Zubek 2004) — users.cs.northwestern.edu
- Transforming Game Difficulty Curves using Function Composition (Sarkar & Cooper CHI 2019) — par.nsf.gov
- Celeste Level Design (Matt Thorson GDC 2017) + Celeste Assist Mode Interviews — Game Developer / Vice 2018-02-07 / Maddy Thorson maddymakesgames.com
- Field Level Design in The Legend of Zelda: Breath of the Wild (CEDEC 2017, Fujibayashi & Yonezu) — Nintendo Dream 273-284 on Notion / 4gamer 自绘示意图 (triangle-rule-1 / triangle-reveal-2)
- Vampire Survivors: Luca Galante / poncle Evolution Story — Birdor 博客 / Wikipedia / GameSpot
- Stardew Valley: ConcernedApe (Eric Barone) Design Philosophy (IGN 2026-02-03) — IGN via Wayback Machine / Stardew Valley Wiki Version_History
- LangGPT: Structured Reusable Prompt Design Framework (arXiv:2402.16929, 2024 v2) — arXiv / GitHub
- Gemini API Prompt Design Strategies + Google AI Studio Build Mode (2026-09) — ai.google.dev / Google Cloud Enterprise Agent Platform / Codelab: Vibe Code with Gemini in Google AI Studio
- Azure OpenAI Advanced Prompt Engineering: System Messages (Microsoft Learn 2026-05-13) — learn.microsoft.com
- 文心一言游戏关卡设计提示词技巧(社区实践贴,土城三富 2025-10-01) — CSDN ADG
- 谷歌 Gemini 游戏关卡设计提示词技巧(社区实践贴,op3721 2025-09-30) — CSDN ADG